Toda medição de marketing digital começa com uma pergunta simples e mal resolvida: o site está contando para as ferramentas o que realmente aconteceu? Quando a resposta é não, o relatório continua bonito e a decisão continua errada.
A causa costuma ser estrutural. As tags leem o que encontram no HTML, o HTML muda em cada publicação, e a medição quebra sem avisar. Entender o que é Data Layer resolve esse ponto na raiz, porque cria um lugar único e estável de onde toda ferramenta lê a mesma informação.
A camada de dados não é uma ferramenta que se contrata. É uma combinação entre quem escreve o código do site e quem configura a medição, e é isso que a torna barata de manter e difícil de improvisar.
O que é Data Layer e por que ele existe?
O Data Layer é um objeto JavaScript que carrega, de forma organizada, as informações que as ferramentas de medição precisam. A documentação da camada de dados descreve o objeto como aquilo que o Google Tag Manager e o gtag.js usam para passar informação às tags, com eventos e variáveis trafegando por ali.
A camada de dados existe porque a alternativa é pior. Sem ela, cada tag precisa encontrar o dado sozinha, lendo o texto de um botão, o conteúdo de uma div ou a estrutura da URL.
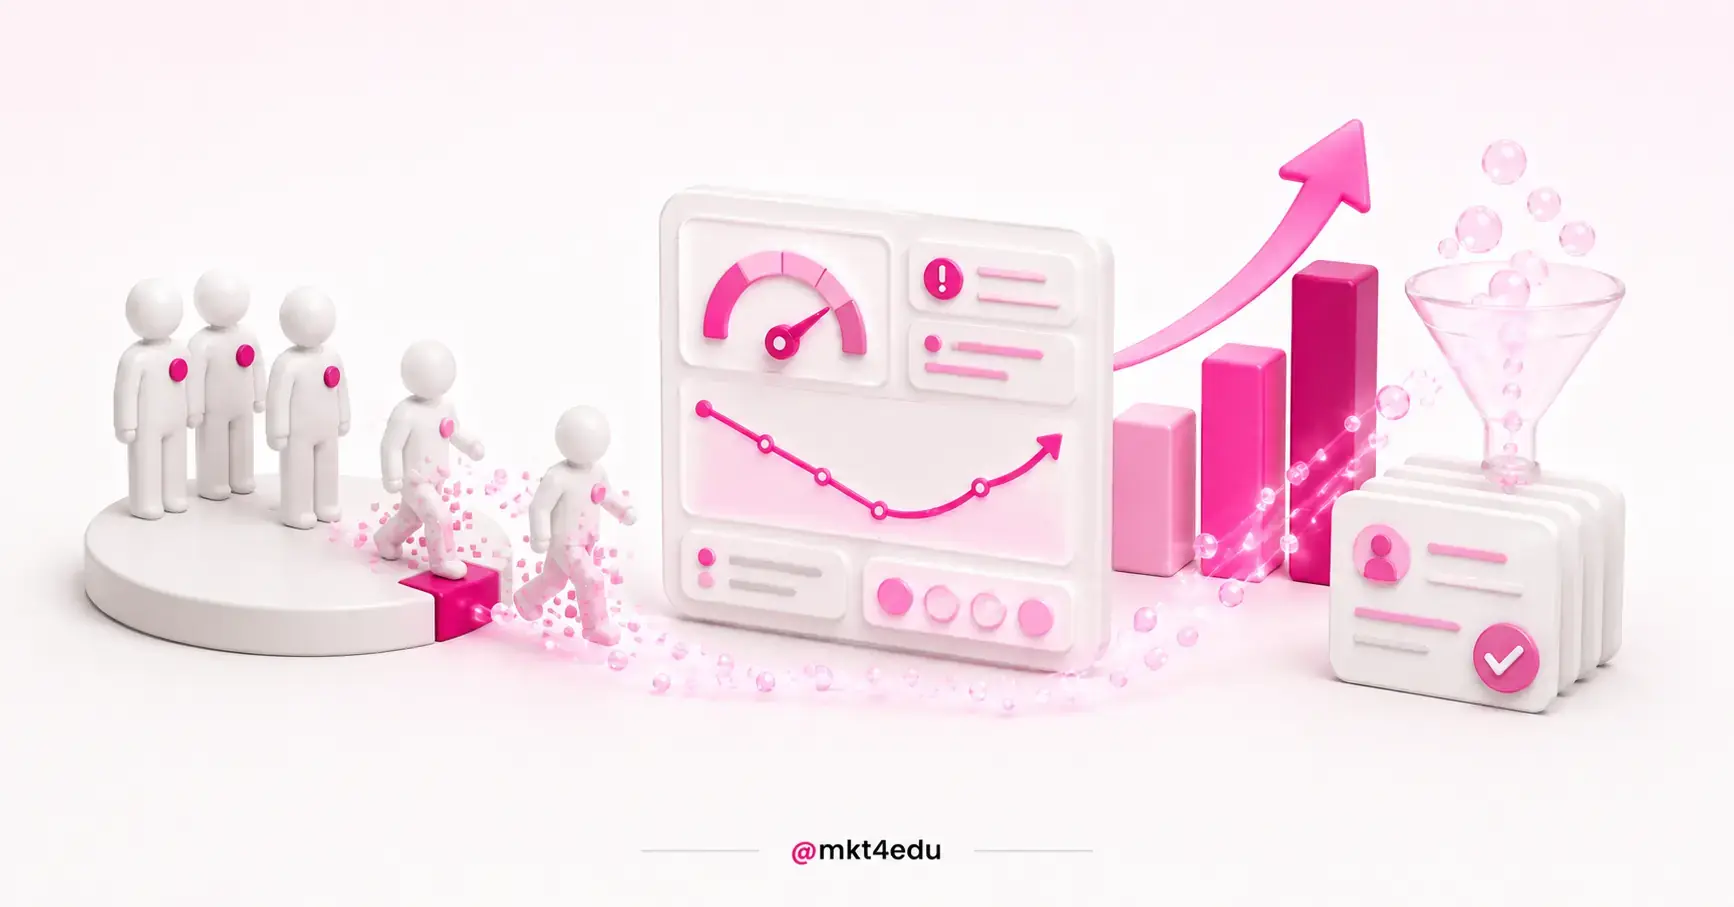
 Legenda: A camada de dados é a fonte única que alimenta cada tag do site, e é ela que separa relatório confiável de número improvisado.
Essa leitura direta do HTML funciona até a primeira mudança de layout. O time de produto renomeia uma classe, a tag para de encontrar o elemento, e o evento simplesmente deixa de existir no relatório sem nenhum erro aparente.
Com a camada de dados, o contrato muda de lugar. O site se compromete a publicar event, value ou transaction_id com nomes fixos, e a ferramenta se compromete a ler exatamente esses nomes.
Duas restrições da documentação valem decorar antes de começar. Só um objeto dataLayer é suportado por página, e o nome do objeto diferencia maiúsculas de minúsculas.
A segunda restrição derruba mais implementação do que parece. dataLayer e datalayer são objetos diferentes para o navegador, então uma letra trocada entre o time de desenvolvimento e o time de mídia produz uma camada que existe e nunca é lida.
Vale definir desde o início de quem é a camada. Ela nasce no código do site, mas quem usa o dado é marketing, e essa fronteira é onde a implementação costuma travar por falta de dono.
O arranjo que funciona é simples: marketing especifica quais eventos precisa e com quais chaves, desenvolvimento publica, e as duas partes guardam o mesmo documento. Sem esse registro, cada nova campanha reabre a discussão do zero.
Por que usar o Data Layer no seu site?
Usar o Data Layer melhora quatro coisas ao mesmo tempo: a precisão do dado coletado, a facilidade de manutenção quando o site muda, a liberdade de personalizar o que é medido e a velocidade de configurar uma tag nova sem depender de fila de desenvolvimento.
A precisão vem da fonte única. Quando duas ferramentas discordam sobre o número de conversões, quase sempre é porque cada uma está lendo um lugar diferente da página.
A manutenção melhora porque o acoplamento diminui. Uma reforma visual do site deixa de ser um evento de risco para a medição, desde que as chamadas da camada de dados continuem publicando as mesmas chaves.
A personalização cresce porque a camada aceita qualquer informação que o negócio considere relevante. Categoria de produto, tipo de página, faixa de valor, etapa do formulário e método de pagamento entram como variáveis próprias.
A velocidade aparece na rotina. Com as chaves já disponíveis, criar uma tag nova passa a ser trabalho de interface, não de código.
O contexto pressiona nessa direção. O State of Marketing 2026 da HubSpot registra que 80% dos profissionais de marketing usam IA na criação de conteúdo e 75% na produção de mídia. O mesmo levantamento aponta que 61% deles consideram que a área vive sua maior disrupção em 20 anos por causa da IA.
Volume de produção sem medição confiável só acelera o erro. Quanto mais rápido o time publica, mais caro fica descobrir três meses depois que o evento de conversão nunca disparou.
Vale separar o que é fato documentado do que é leitura de mercado. A definição e as restrições técnicas estão na documentação do Google; a afirmação de que camada de dados reduz retrabalho é consenso de operação, e tende a se confirmar em sites que mudam de layout com frequência.
Como configurar o Data Layer no Google Tag Manager?
Configurar o Data Layer no Google Tag Manager tem quatro passos, e a ordem importa. Primeiro o site publica o objeto, depois o contêiner declara a variável que vai ler aquele valor, então o acionador e a tag são montados, e só no fim a versão vai ao ar.
Passo 1: criar o objeto dataLayer no site
O objeto precisa ser declarado antes do trecho de código do contêiner, para que os valores já estejam disponíveis quando o Google Tag Manager carregar. Um dataLayer declarado depois do contêiner existe, mas chega tarde para os acionadores que dependem dele no carregamento da página.
Nessa etapa também se decide o dicionário. Quais chaves existem, que tipo de valor cada uma aceita e quem é responsável por publicá-las são decisões que valem mais escritas do que combinadas verbalmente.
Passo 2: declarar a variável da camada de dados no GTM
No painel de variáveis, cada chave publicada pelo site vira uma variável do tipo camada de dados. O nome preenchido ali precisa ser idêntico ao nome usado no código, incluindo maiúsculas e minúsculas.
É comum criar variáveis para event, value, currency, transaction_id, page_type e para os identificadores de produto. Cada uma passa a estar disponível para qualquer tag do contêiner.
Passo 3: montar o acionador e a tag
O acionador define quando a tag dispara, e a camada de dados é o que dá material para essa condição. Um acionador de evento personalizado escuta o nome publicado pelo site, e pode ainda filtrar por valor de variável para não disparar em todo caso.
A tag consome as variáveis já declaradas. É aqui que o dado sai do site e chega ao destino, seja o Google Analytics 4, seja uma plataforma de mídia.
Passo 4: publicar a versão do contêiner
A publicação cria uma versão nomeada do contêiner, com histórico e possibilidade de retorno. Publicar sem descrição funciona, mas transforma o histórico em uma lista de datas sem significado quando algo quebra semanas depois.
Antes de publicar, o modo de visualização mostra o comportamento real em uma sessão de depuração. Essa conferência é o assunto de uma seção adiante, e pular ela é a origem mais comum de evento duplicado em produção.
Como o Data Layer alimenta o Google Analytics 4?
A camada de dados alimenta o Google Analytics 4 por meio da tag do Google. Segundo a documentação de configuração, a tag do Google é o que permite que os dados fluam do site para o Analytics e para os outros destinos configurados.
O fluxo é direto. O site publica um evento na camada de dados, o acionador reconhece o nome do evento, a tag lê as variáveis e envia tudo ao Analytics com os parâmetros combinados.
O que garante relatório útil não é o volume de eventos, é a consistência dos nomes. O Google mantém uma lista de eventos recomendados do GA4, que exigem contexto adicional para fazer sentido e por isso não são enviados automaticamente.
Adotar esses nomes é o caminho mais curto para relatório pronto. Veja como os principais se organizam por objetivo de negócio:
|
Objetivo |
Evento recomendado |
O que a camada precisa publicar |
|
Venda online |
purchase |
transaction_id, value, currency, items |
|
Venda online |
add_to_cart |
items, value, currency |
|
Geração de leads |
generate_lead |
value, currency |
|
Geração de leads |
qualify_lead |
value, currency, lead_source |
|
Geração de leads |
close_convert_lead |
value, currency |
Tabela: Eventos recomendados do GA4 para venda online e geração de leads, conforme a documentação do Google, com as chaves que a camada de dados precisa entregar.
Os eventos de lead têm um efeito colateral bem-vindo. A própria documentação registra que enviar essa família de eventos alimenta o relatório de aquisição de leads, o que dispensa construir a visão do funil manualmente.
Quem quiser fechar o ciclo até a etapa comercial encontra na leitura do funil de conversão o desdobramento natural desses eventos. Sem a camada de dados publicando value e currency, o funil existe e não informa receita.
Como criar um evento personalizado com dataLayer.push?
Um evento personalizado nasce de uma chamada dataLayer.push no momento em que a ação acontece no site. A chamada carrega o nome do evento e os dados que ele precisa levar, e o Google Tag Manager reage a esse nome por meio de um acionador de evento personalizado.
A anatomia é sempre a mesma. A chave event recebe o nome que o acionador vai escutar, e as outras chaves carregam o contexto: identificador, valor, moeda, categoria ou etapa.
O nome do evento é uma decisão de arquitetura, não de estilo. purchase e compra_finalizada funcionam igualmente bem para o navegador, mas só o primeiro conversa com os relatórios prontos do Analytics e com a documentação que o próximo analista vai consultar.
Três cuidados evitam a maioria dos problemas. Publique o evento uma única vez por ação, envie o valor como número e não como texto formatado, e nunca coloque dado pessoal identificável na camada.
O terceiro cuidado costuma ser descoberto tarde. A camada de dados fica visível no navegador de qualquer visitante, então e-mail, telefone e documento publicados ali viram exposição, não medição.
Em sites de conteúdo, a mesma mecânica serve para medir profundidade de leitura, uso de busca interna e cliques em elementos de navegação. Esses eventos ajudam a diagnosticar por que a taxa de conversão não sobe mesmo com tráfego crescente.
Como testar o Data Layer antes de publicar?
Testar o Data Layer significa abrir uma sessão de depuração e conferir três coisas: se o evento aparece, se aparece uma única vez e se as variáveis chegam com o valor certo. O modo de visualização do Google Tag Manager mostra isso em tempo real, antes de qualquer publicação.
A ferramenta oficial para essa conferência é o Tag Assistant. A documentação sobre como navegar no Tag Assistant descreve que, ao iniciar uma sessão de depuração, o painel apresenta as informações das tags e dos eventos da página.
O roteiro de teste é curto e vale repetir a cada mudança. Percorra a jornada como um visitante faria, observe a sequência de eventos na linha do tempo e clique em cada um para inspecionar as variáveis disponíveis naquele momento.
Três defeitos aparecem com frequência nesse exame. O evento dispara duas vezes porque a chamada ficou dentro de um trecho executado em duplicidade, a variável volta vazia porque o nome divergiu do código, ou o valor chega como texto e o relatório não soma.
Um quarto defeito é mais silencioso. O evento dispara antes de a camada estar preenchida, então a tag envia o nome correto com as variáveis em branco.
Um detalhe do teste engana com frequência. O modo de visualização roda a versão de rascunho do contêiner, então uma configuração aprovada ali só passa a valer no site depois da publicação.
Conferir em produção fecha o ciclo. Depois de publicar, repita a mesma jornada com o Tag Assistant aberto e compare a sequência de eventos com a que você viu no rascunho.
A validação de implementação técnica segue a mesma lógica de outras camadas invisíveis do site. Quem já enfrentou erros de JSON-LD reconhece o padrão: o problema não aparece na tela, só no que a máquina lê.
O que muda no Data Layer com consentimento e server-side?
Consentimento e marcação server-side mudam quando e por onde o dado da camada trafega, sem mudar o princípio. A camada continua sendo a fonte única, mas passa a operar sob permissão do visitante e, em algumas arquiteturas, a enviar o dado para um contêiner de servidor antes de chegar ao destino final.
O modo de consentimento permite ajustar o comportamento das tags conforme a escolha do visitante. Na versão básica, as tags do Google não carregam até a interação com o banner; na versão avançada, carregam junto com a página e respeitam o estado do consentimento.
Os tipos de consentimento são sete, e cada um governa uma finalidade específica: ad_storage, ad_user_data, ad_personalization, analytics_storage, functionality_storage, personalization_storage e security_storage. Tratar todos como um interruptor único é o erro clássico dessa etapa.
A marcação server-side move o processamento das tags para um contêiner de servidor. A documentação aponta três ganhos: desempenho de página, controle mais detalhado de privacidade e qualidade de dados.
Do lado das plataformas de mídia, o vocabulário mudou e vale acompanhar. A API de Conversões da Meta conecta os dados de marketing do anunciante aos sistemas da Meta para otimizar direcionamento, reduzir custo por resultado e mensurar resultados. A documentação atual fala em identificador de conjunto de dados, e não apenas em identificador de pixel.
Uma correção de nome importa aqui. O componente instalado no site é o Pixel da Meta, e a documentação da empresa não usa mais o nome antigo, ainda comum em tutoriais e em painéis internos desatualizados.
Quem compara investimento entre plataformas depende dessa camada para enxergar o retorno real. A escolha entre Google Ads ou Meta Ads só é decidível quando as duas contas recebem o mesmo evento, com o mesmo valor, pela mesma fonte.
E é a partir dessa base limpa que análise mais avançada fica possível. Modelos de propensão e projeções de data science aplicados ao marketing não consertam evento faltante, eles herdam o problema e o multiplicam.
Perguntas frequentes sobre o que é Data Layer
Vale a pena estruturar o Data Layer agora?
Vale, e o argumento não é técnico. Uma camada de dados bem definida é o que separa relatório que orienta decisão de relatório que só ocupa reunião, e o custo de arrumar cresce a cada campanha rodada sobre uma base torta.
O começo é modesto de propósito. Escolha os dois ou três eventos que representam dinheiro no seu negócio, combine as chaves com quem escreve o código, publique, teste no modo de depuração e só então expanda.
Seu site dispara tags. Ele mede o que importa? Uma camada de dados bem montada mostra quais eventos estão chegando quebrados no relatório, e o caminho completo de configuração está em como usar o Google Tag Manager para monitorar suas vendas.
Sem uma camada de dados bem montada não dá para segmentar a audiência no Google Analytics com precisão.










 Portugal