Publicar um conteúdo e não encontrá-lo na busca no dia seguinte gera uma reação quase automática dentro das equipes, que é mexer no texto. O problema é que a indexação do Google raramente falha por causa do texto. Ela falha, atrasa ou nem começa por razões que acontecem antes de qualquer pessoa ler o artigo.
Em outubro de 2026, o Google divulgou pela primeira vez faixas de tempo observadas para cada etapa desse caminho. Os números mudam a conversa, porque transformam uma angústia difusa em diagnóstico com prazo.
Este artigo organiza essas faixas, explica o que elas significam e, principalmente, o que elas não significam.
Quais são as três etapas da indexação do Google?
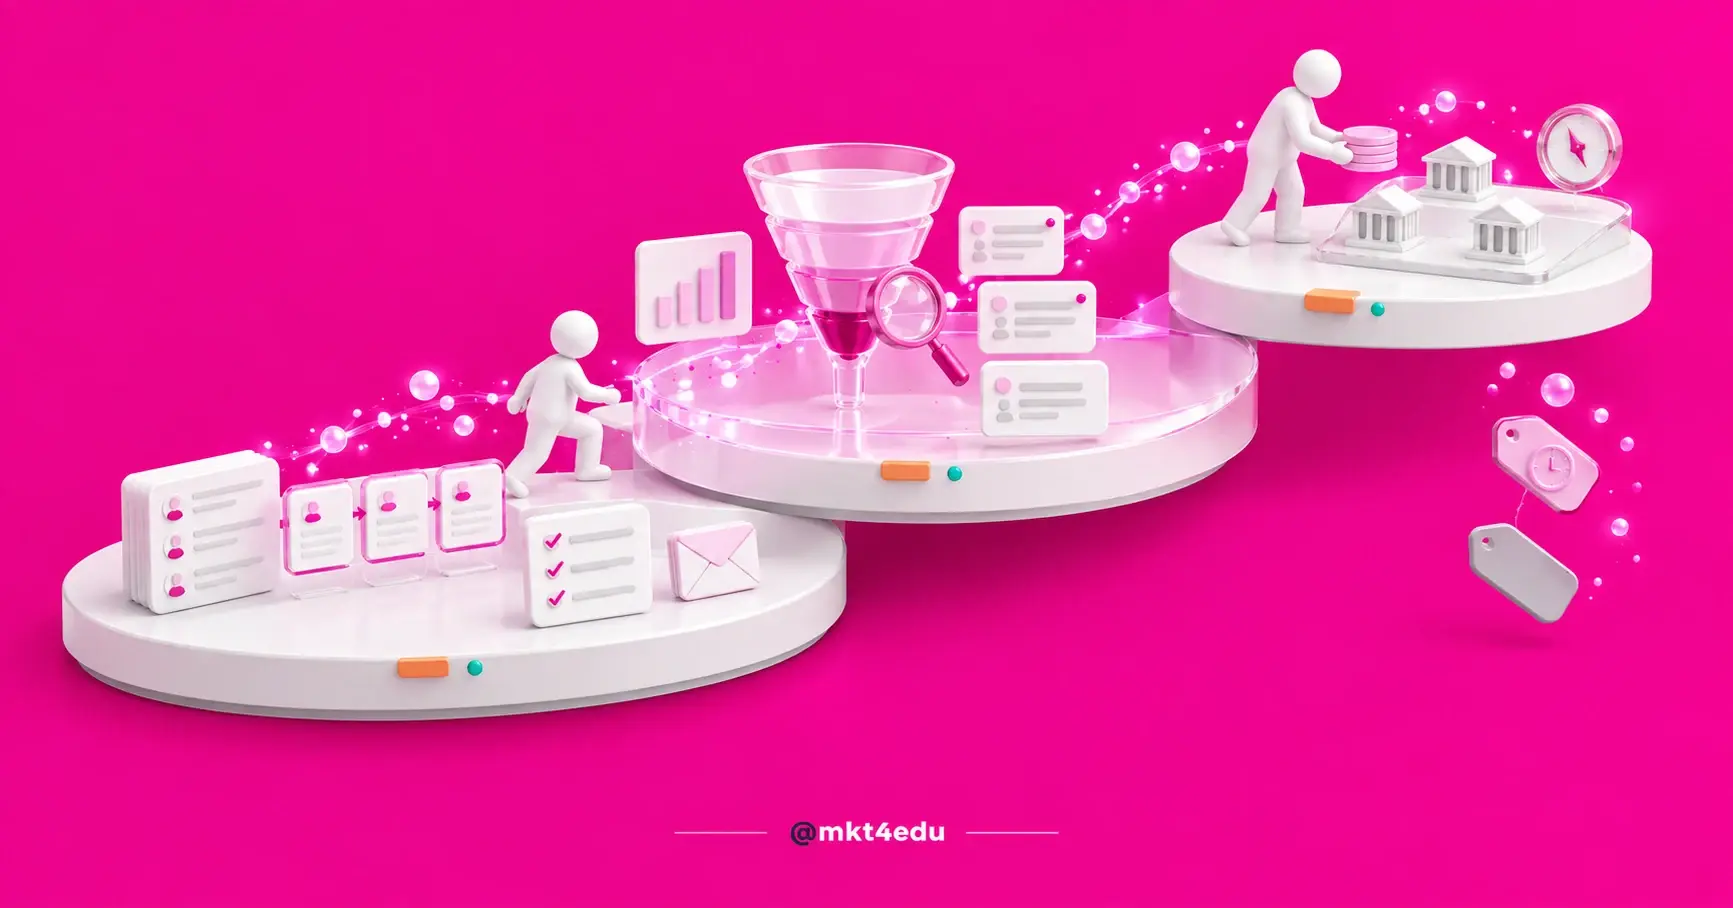
A indexação do Google é a segunda de três etapas. Primeiro vem o rastreamento, em que programas automatizados baixam o conteúdo das páginas. Depois vem a indexação, em que o buscador analisa esse conteúdo e o guarda no índice. Por último vem a exibição, em que o sistema escolhe o que mostrar para cada consulta.
 Legenda: a indexação do Google é o portão do meio: a página precisa ser rastreada antes e escolhida depois
O Google não garante que vai rastrear, indexar ou exibir uma página, mesmo que ela siga todas as diretrizes de qualidade. A frase abre a própria explicação oficial sobre como a busca funciona, e convém guardá-la.
Essa ressalva muda a natureza da pergunta. Não existe fila com senha nem prazo contratado, existe probabilidade.
O que cada etapa decide é diferente, e por isso o diagnóstico precisa ser feito etapa por etapa. Rastreamento decide se o conteúdo foi visto. Indexação decide se ele foi compreendido e guardado. Exibição decide se ele compete por uma consulta.
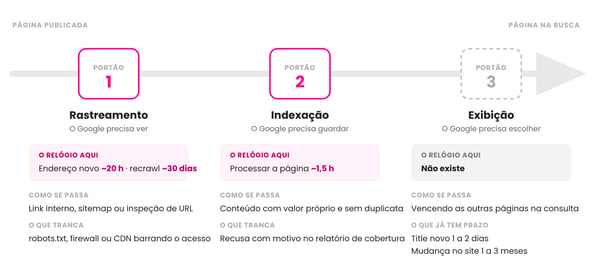 Legenda: os três portões entre publicar e aparecer na indexação do Google; como os processos são encadeados, os atrasos se somam, e as faixas são tempos observados e divulgados pelo Google, sem compromisso nem acordo de nível de serviço
A separação entre a segunda e a terceira etapa é a que mais confunde times de marketing. Estar indexado significa ser elegível, não significa ser escolhido. A página pode estar perfeitamente no índice e nunca aparecer, porque perde para outras na consulta que você espera atender.
Quem está fazendo esse diagnóstico pela primeira vez encontra o passo a passo de verificação no guia sobre o que decide se um blog post aparece no Google, que trata da camada editorial e de elegibilidade. Aqui o foco é outro: o relógio.
Vídeo: as camadas de otimização que atuam em cada etapa da indexação do Google, no canal da mkt4edu
Quanto tempo demora para o Google indexar um site?
Em outubro de 2026, Gary Illyes, analista do Google, apresentou faixas de tempo observadas para cada etapa durante o evento Search Central Live Deep Dive, na Europa. São os primeiros números públicos que permitem comparar o caso típico com o pior caso de cada processo.
Antes dos números, a ressalva que veio junto com eles, e que é tão importante quanto a tabela. Illyes afirmou que os processos são encadeados: uma página não pode ser indexada antes de ser rastreada, então os atrasos de uma etapa se somam aos da seguinte.
Mais importante ainda, essas faixas são observações, não compromisso. Não existe acordo de nível de serviço do Google com nenhum site, e nada nessa sequência é garantido.
Com isso em mente, veja como as faixas se distribuem:
|
Processo |
Caso típico |
Pior caso |
|
Descoberta de uma URL nova |
cerca de 20 horas |
semanas ou nunca |
|
Novo rastreamento de uma URL conhecida |
cerca de 30 dias |
semanas ou nunca |
|
Processamento de indexação |
cerca de 1,5 hora |
meses ou nunca |
|
Efeito de uma mudança no site |
1 a 3 meses |
6 meses a 1 ano |
|
Remoção solicitada no Search Console |
cerca de 2 horas |
24 horas |
|
Atualização de título na busca |
1 a 2 dias |
semanas ou meses |
Tabela: faixas de tempo por processo da busca, apresentadas por Gary Illyes no Search Central Live Deep Dive de outubro de 2026 e reportadas por Search Engine Roundtable e Search Engine Journal
A leitura mais útil da tabela não está em nenhuma linha isolada, está na distância entre as colunas. Processos cujo caso típico é medido em horas têm pior caso medido em meses, e isso significa que a média engana.
A mesma apresentação trouxe faixas para as Atualizações do Google, e elas ficam em outra ordem de grandeza. A recuperação de um site depois de um core update leva de três a seis meses no caso típico e pode chegar a um ano, enquanto o efeito de uma atualização de spam aparece em uma a duas semanas.
Para uma instituição de ensino, a linha mais cara costuma ser a quarta. Uma mudança estrutural no site leva de um a três meses para mostrar efeito, o que não combina com ciclo de campanha de captação, que roda em semanas.
Por que a descoberta de uma URL nova é o gargalo real?
A descoberta é o gargalo porque o processamento de indexação leva cerca de uma hora e meia, enquanto encontrar o endereço leva cerca de vinte horas no caso típico. O tempo não está em entender a página, está em achar que ela existe. E, no pior caso, o endereço pode simplesmente nunca ser encontrado.
O rastreador do Google não varre a internet procurando novidades às cegas. Ele chega a uma URL (Uniform Resource Locator, o endereço da página) por caminhos concretos: um link em outra página já conhecida, uma entrada em um arquivo de mapa do site, ou um pedido manual de inspeção.
Daí vem a consequência prática: uma página sem nenhum link apontando para ela e fora do mapa do site depende de sorte. Publicar não é um evento que notifica o buscador.
Esse é o motivo pelo qual conteúdo novo em site com publicação frequente aparece rápido, e conteúdo novo em site parado demora. A frequência de rastreamento é aprendida, e um endereço que nunca muda recebe menos visitas do rastreador.
Há ainda uma camada anterior, que é a de acesso. Se uma regra de servidor, de firewall ou de rede de distribuição de conteúdo bloquear o rastreador, a contagem nem começa, e o diagnóstico de como validar o rastreamento do Googlebot resolve antes de qualquer discussão sobre prazo.
Vale separar as duas falhas, porque elas se parecem no sintoma. Bloqueio de acesso produz página que nunca entra no índice. Descoberta lenta produz página que entra depois, e a diferença aparece no relatório de cobertura.
Quanto tempo demora para o Google atualizar o título de uma página?
A troca de título leva de um a dois dias para aparecer nos resultados no caso típico, e pode levar semanas ou meses no pior caso. A razão é direta: o texto novo só é exibido depois que a página é rastreada de novo, e esse rastreamento acontece em torno de trinta dias.
Esse descompasso explica uma frustração comum nas equipes. Alguém reescreve o título de dez páginas em uma tarde, confere a busca no dia seguinte e conclui que a alteração não foi salva. Ela foi salva, mas ainda não foi vista pelo rastreador.
Existe uma segunda camada, independente de prazo, que vale conhecer. O Google nem sempre usa o título que você escreveu, porque ele gera o texto exibido a partir do conteúdo da página quando julga que outro recorte descreve melhor o documento.
Na prática, isso significa que esperar o prazo é condição necessária e não suficiente. Se depois de semanas o título antigo continua aparecendo, o problema deixou de ser tempo e passou a ser pertinência entre título e conteúdo.
Para quem trabalha com páginas de curso, a recomendação operacional é agrupar alterações. Mexer no título de um lote de páginas em uma única janela e medir o conjunto quarenta e cinco dias depois produz leitura mais confiável do que conferir página a página.
Google Search Console: para que serve no diagnóstico de indexação?
O Google Search Console serve para responder, com dado do próprio buscador, em qual etapa a página parou. Ele mostra se a URL foi descoberta, se foi rastreada, se foi indexada e, quando não foi, qual motivo o sistema registrou. É a única fonte que não depende de interpretação.
A ferramenta de inspeção de URL é o ponto de partida do diagnóstico. Ela responde a pergunta binária que importa, que é se a página está ou não no índice, e informa a data do último rastreamento.
Essa data é o número mais subestimado do painel. Comparada com a data da sua última edição, ela diz na hora se o buscador já viu a versão nova ou se você está olhando para um retrato antigo.
O relatório de cobertura, por sua vez, serve para padrão, não para caso isolado. Uma URL não indexada é ruído, enquanto trinta URLs não indexadas com o mesmo motivo são um problema de estrutura.
Quem está montando a rotina de acompanhamento encontra a leitura completa dos relatórios no material sobre como funciona o Google Search Console, que cobre a configuração e a interpretação painel a painel.
Uma observação sobre o pedido de indexação manual. Ele existe, funciona para casos pontuais e não escala, porque tem limite diário e não substitui estrutura de links e mapa do site.
Como criar um sitemap para o Google acelerar a descoberta?
Criar um sitemap para o Google significa publicar um arquivo que lista os endereços do site e enviá-lo pelo Search Console. Ele atua exatamente na etapa que trava, que é a descoberta, ao entregar a lista de URLs em vez de esperar que o rastreador encontre cada uma por link.
Dois pontos do mapa do site costumam ser ignorados. O primeiro é que o arquivo ajuda na descoberta, mas não garante que tudo que está nele será rastreado e indexado.
O segundo é que nem todo site precisa de um. Um site pequeno, com cerca de quinhentas páginas ou menos e com boa ligação interna entre elas, tende a ser descoberto sem o arquivo.
Sites de instituições de ensino quase nunca se encaixam nessa descrição. Entre páginas de curso, polos, blog, formulários de inscrição e materiais, o volume passa de quinhentas páginas rápido, e aí o arquivo deixa de ser opcional.
O formato mais comum é o XML (Extensible Markup Language, a linguagem de marcação usada no arquivo), e a maioria das plataformas de gestão de conteúdo o gera automaticamente. O trabalho humano não está em criar o arquivo, está em conferir o que entrou nele.
Três erros aparecem com frequência quando ninguém confere:
- Endereços que retornam erro ou redirecionamento continuam listados depois de uma reformulação do site.
- Páginas marcadas para não serem indexadas aparecem no arquivo, o que envia instruções contraditórias.
- O arquivo não é atualizado quando a estrutura de cursos muda, e o mapa descreve um site que não existe mais.
Nenhum desses erros derruba um site, e é justamente por isso que eles duram anos. O efeito é de atrito acumulado na descoberta, não de queda súbita.
O que a indexação do Google significa no mecanismo de busca com IA?
A indexação do Google virou pré-requisito também para a busca com IA (Inteligência Artificial), porque os recursos generativos do buscador trabalham sobre o mesmo índice e os mesmos sistemas de classificação da busca tradicional. Página fora do índice não é citada em resumo gerado por IA, por melhor que seja o texto.
Isso desfaz uma expectativa que circula bastante nas equipes, que é a de existir um caminho paralelo para aparecer nas respostas geradas. Não existe atalho que dispense a etapa técnica.
A consequência é confortável para quem já faz o básico. O mesmo trabalho de descoberta, rastreamento e indexação que sustenta o tráfego orgânico sustenta a elegibilidade para citação.
O que muda é a unidade que compete. Sistemas generativos recuperam trechos, não documentos inteiros, então um artigo indexado com parágrafos autossuficientes tem mais chance de ser citado do que um artigo indexado com blocos longos e dependentes de contexto.
Indexar resolve a elegibilidade, e o que acontece depois do clique é outra disciplina. Essa camada de experiência da busca é o que o SXO (Search Experience Optimization) organiza, e ela não substitui nenhuma das etapas técnicas.
A distinção entre as camadas de otimização, incluindo o que pertence ao SEO (Search Engine Optimization, otimização para mecanismos de busca) clássico e o que pertence à resposta gerada, está detalhada na comparação entre SEO, AEO e GEO.
Para quem usa IA generativa na produção, há um cuidado adicional de revisão que afeta diretamente o que vai para o índice, descrito no material sobre como criar conteúdo com IA sem destruir seu SEO.
Vídeo: a lógica de competir por página depois de resolvida a indexação do Google, no canal da mkt4edu
Como calibrar a expectativa da diretoria sobre prazo orgânico?
Calibrar a expectativa significa separar, na conversa com a diretoria, três prazos que costumam ser tratados como um só: o prazo de a página existir na busca, o prazo de uma mudança estrutural mostrar efeito e o prazo de a página competir por uma consulta. Eles são diferentes e têm ordens de grandeza diferentes.
O primeiro prazo é curto e técnico. Entre publicar e estar no índice, o caso típico soma menos de um dia, e ele pode ser verificado objetivamente na inspeção de URL.
O segundo é o que mais frustra, porque vai de um a três meses. Qualquer reorganização de arquitetura, mudança de endereços ou limpeza de páginas entra nessa faixa, e cobrar resultado em quatro semanas é cobrar antes do tempo de resposta do sistema.
O terceiro prazo não tem número confiável, porque depende da concorrência da consulta e não do buscador. É aqui que a expectativa precisa ser construída com dado do próprio site, não com referência de mercado.
Vale abrir um quarto prazo quando o assunto são as atualizações do Google. Recuperação depois de um core update é medida em trimestres, não em semanas, e tratar isso como problema de indexação leva a equipe a mexer no que não é a causa.
Uma forma honesta de apresentar isso em reunião é inverter a pergunta. Em vez de prometer quando o conteúdo vai ranquear, mostre em qual etapa cada página está hoje, com a data do último rastreamento ao lado.
Esse recorte muda o tom da conversa porque transforma uma promessa em um relatório de estado. E deixa visível quando o problema é de prazo, quando é de acesso e quando é de concorrência.
Quando o volume de páginas torna esse acompanhamento manual inviável, estruturar a rotina técnica junto da editorial é o que sustenta o resultado, e é o escopo de um trabalho contínuo de SEO.
Perguntas frequentes sobre indexação do Google
Por onde começar a destravar a indexação do Google?
Comece pelo diagnóstico, não pelo conteúdo. Antes de reescrever qualquer texto, abra a inspeção de URL do Search Console e descubra se a página está no índice e quando foi rastreada pela última vez, porque essas duas informações eliminam a maior parte das hipóteses erradas.
Se a página não foi descoberta, o trabalho é de links internos e mapa do site. Se foi descoberta e não indexada, o relatório de cobertura nomeia o motivo. Se está indexada e não aparece, o problema é de concorrência e aí sim entra a discussão editorial.
A mudança de postura que esses prazos permitem é parar de tratar ausência na busca como um problema único. São três problemas com três relógios diferentes, e tratar o errado consome ciclo de campanha inteiro.
Em sites com muitas páginas e histórico de reformulações, esse mapeamento costuma revelar lotes inteiros parados na mesma etapa. Vale para um catálogo de cursos, para uma operação com dezenas de páginas de produto ou para um site de serviços que já trocou de plataforma mais de uma vez.
Se esse é o seu cenário, fale com a nossa equipe para avaliar o estado de indexação do seu domínio e priorizar o que destrava mais tráfego primeiro.










 Portugal